Dify 推出 Knowledge Pipeline 可视化流程,将企业杂乱数据转化为高质量 LLM 上下文
Dify 推出 Knowledge Pipeline 可视化流程,将企业 PDF、PPT、Excel 等杂乱数据转化为高质量 LLM 上下文。该流程通过可视化节点管理数据源连接、文档解析、文本/图像/表格处理、知识蒸馏和嵌入等步骤,支持 30+ 格式本地文件、云存储、在线文档、网络爬虫等数据源,提供 7 种预设模板和可插拔的解析、增强、分块、嵌入、加载模块,具备实时变量调试功能。
Dify v0.15.0 推出父子检索技术,通过匹配小粒度子片段实现精准检索,结合大粒度父片段补充上下文,提升 RAG 系统的响应准确性与信息丰富度。该功能支持两种父片段分割模式(段落/全文),允许用户独立编辑父子片段并选择是否再生子片段,同时优化了片段预览界面以增强低代码平台易用性。
Dify.AI 将 Jina Embeddings 模型整合至平台,该模型支持 8,192 个 token 的上下文长度,优于多数仅支持 512 token 的开源模型。
混合搜索和重新排序技术显著提升 RAG 系统的文档召回率和准确率,混合搜索结合语义相关性和关键词匹配优势,重新排序技术优化候选结果排序,适用于客户服务机器人、企业知识库等场景。
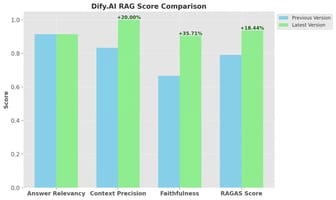
Dify.AI v0.3.31 更新通过混合搜索、语义重排模型和多路径检索增强 RAG 技术,使其问答效率提升 20%,显著优于 OpenAI Assistants API。Ragas 评测显示 Ragas 分数提高 18.44%,上下文精确度提升 20%,忠实度提高 35.71%。