Hugging Face Daily Papers7575
OpenDS-World:用于评估真实网络环境自主深度搜索智能体的基准
OpenDS-World 引入一个实时网络基准来评估自主多步深度搜索智能体,揭示前沿模型与人类表现之间存在显著差距。在 12 个前沿模型中,最佳模型准确率达到 39.0%,而 1000 次人类评估准确率为 21.1%。分析显示模型间研究策略存在差异,且工具协调和长时程搜索管理仍是主要挑战。
Hugging Face Daily Papers7575OpenDS-World 引入一个实时网络基准来评估自主多步深度搜索智能体,揭示前沿模型与人类表现之间存在显著差距。在 12 个前沿模型中,最佳模型准确率达到 39.0%,而 1000 次人类评估准确率为 21.1%。分析显示模型间研究策略存在差异,且工具协调和长时程搜索管理仍是主要挑战。
 Latent Space7575
Moshi推出商品交易推荐引擎,连接市场信息与交易者核心需求。该引擎整合市场数据、工作界面及定制化推荐,帮助交易者处理海量信息。Moshi CEO Anekha Sokhal强调,实用AI需融入实际工作流程。
 Meta Engineering
GenRecs Tokenization 通过将广告、产品等项用稳定语义词汇表表示,结合 Meta 生成式广告模型(GEM)和自适应排序模型,为广告主带来 0.35% 的转化率提升。该技术利用预训练大模型的世界知识,使推荐系统能理解新项目或无历史交互的用户偏好,并通过共享概念加速学习、实现跨活动迁移、随大模型规模提升性能,形成性能改进的反馈循环。
 Inception Labs Blog
Mercury 2在标准NVIDIA GPU上每秒解码超过1000个token,比Gemini 3.1 Flash Lite在查询规划阶段快近2倍、比Claude Haiku 4.5快4.7倍、比GPT-5 Mini快10倍,每个查询步骤都快于其他模型,使其能在现有延迟预算内完成搜索流程的每一步。
Inception Labs BlogInception Labs推出Mercury 2,免费token数量从10M增至100M,新Inception API key包含100M免费token,免费套餐请求频率提升10倍。Mercury 2在实时语音、搜索、AI编码子智能体和多智能体工作流中表现更佳,首token响应时间缩短,端到端延迟降低,工具调用更可靠。
Inception Labs Blog7575SearchBlox SearchAI 现在集成了 Inception 的 Mercury dLLM,为企业级工作负载提供亚秒级 GenAI 响应。该合作使 SearchBlox 客户在电商、客服、知识管理等场景中,以 60-90% 的推理成本降低和可扩展的速度获得实时搜索。
 Google DeepMind
Google Antigravity 平台通过其智能体工作台和 ProtNLM 模型,帮助生物学家快速发现、结构评估和优先排序有潜力的抗菌肽靶点,将以往分散在多个数据库的搜索压缩为单次会话。该平台利用 ProtNLM 预测蛋白质功能,并支持研究人员扫描 UniProt 数据库中数百万个未表征的蛋白质。研究人员与 AI 代理在共享的 3D 画布上协作,将抗菌肽发现流程所需时间从数天压缩至单次会话。
 Apple Machine Learning Research
选择式结构化推理 (SSR) 框架将推理重构为选择而非开放式生成,在每次行动前从预定义的推理候选中选择最可能的方案,显著降低推理成本。使用 2B 和 4B 模型在七项多模态搜索基准测试中验证,SSR 实现了平均成功率与同等规模领先搜索智能体相当,单步推理延迟降低 90%,单题总推理延迟减少 28-54%。
 LangChain Blog
LangSmith 推出 AI 搜索功能,支持用自然语言查询智能体行为追踪记录。该功能可搜索用户输入、智能体推理、工具调用及响应等内容,帮助团队发现特定行为模式,如 PII 泄露或用户挫败感等。AI 搜索结合 SmithDB 数据层和决策模型,通过分析标准化轨迹而非原始长文本,实现跨 SDK 的快速高效搜索,优先处理用户消息和智能体回复等关键信息。
 n8n Blog
Jev 对每篇新闻回答三个问题筛选出真正重要的发展,You.com 节点搜索每日新闻并去重,You.com Research 为每个主题撰写简短摘要并通过 Slack 发布,整个流程成本低于四美分,有效避免无关信息干扰。
 Google Developers Blog
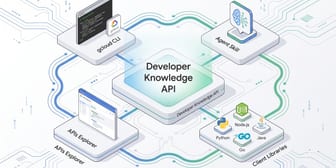
Google Developer Knowledge API 是 Google 官方的开发者文档程序化源,为 Google Cloud、Firebase、Android 等 Google 生态提供语义搜索、智能文档分块和可靠问答能力,减少 AI 工具因 LLM 训练截止日期过时而产生的幻觉。
 Cohere Blog7575
Cohere 推出 RCP-nDCG@10,通过校准 AI 评委对每份检索文档进行评分,弥补传统 nDCG@k 依赖人工标注导致遗漏相关结果的缺陷,以优化下一代搜索模型。该指标结合了文档排序和相关性评估,通过 AI 判定每份文档的实际相关性,而非仅依赖原始标注。
 Factory News7575
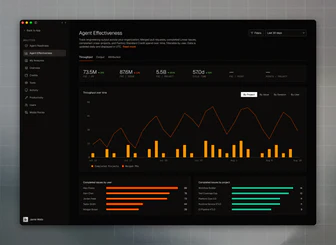
Factory 的 Agent Effectiveness 功能现已上线,将使用数据与交付周期、工作意图及已交付成果关联,帮助工程领导者了解交付加速点、机器人工作内容及使用如何映射到实际产出。该功能通过连接 Droid 使用与交付结果,提供 AI 投资回报的操作性视图,回答交付速度变化、收益集中点及新增能力是否用于优先工作等问题。
 Prime Intellect Blog
Prime Intellect 整合了 23 个用于软件工程、终端和搜索的智能体任务集,提供统一 API、运行时/沙盒钩子,包含约 198,000 个软件工程任务、28,600 个终端任务和 137,600 个搜索任务。通过 verifiers v1 将环境分解为任务集、沙盒和运行时三层,标准化了不同任务集的评分逻辑,并提供 135,000 个预构建的开源任务镜像。
 Qoder Blog00
Qoder Agent 通过 Agent-Driven Code Retrieval 技术,将检索效率提升 3.5 倍,支持上下文窗口 8k tokens,可在云端部署并集成 IDE。
LangChain BlogLangChain Deep Agents SDK 通过三种压缩技术管理 AI 代理的有限内存:将大型工具结果(>20,000 tokens)和输入(>85% 上下文窗口)卸载到文件系统,以及使用 LLM 生成会话摘要。该 SDK 在 Claude Sonnet 4.5 上终端基准测试中触发压缩,通过文件系统搜索和摘要保留完整记录,支持频繁触发压缩以优化性能。
 Dify Blog7070
Dify 平台现整合 Qdrant 高性能 Rust 向量数据库,为构建可靠、生产级 AI 应用提供更快检索、混合搜索和可扩展性能。该集成使开发者无需成为向量搜索专家,即可通过简单配置选择 Qdrant,实现百万级文档的毫秒级检索、基于元数据的复杂检索策略和混合搜索能力,支持从原型到生产的高性能扩展。
Dify Blog6565Dify 平台现支持 Tavily 实时网络搜索 API,用户可直接将网络数据嵌入知识管道以提升准确性和时效性;Tavily 可作为 Dify 市场中的数据源插件,配合 Dify 知识管道使用,后者支持从上传解析到分块嵌入的模块化组件;用户可通过安装插件、获取 API 密钥并配置 LLM 节点,将 Tavily 搜索结果用于生成问答对并存储于知识库。
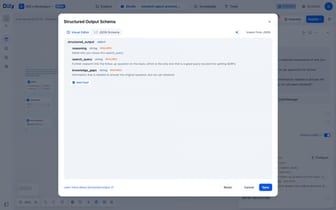
Dify BlogDify 通过循环变量、结构化输出和 Agent 节点构建深度研究工作流,实现迭代探索与综合报告生成。工作流包含意图识别、动态研究循环(含六变量追踪)和研究成果合成三个阶段,Agent 节点利用 exa_search、exa_content 和 think 工具完成信息收集与处理。最终输出带引用的 Markdown 报告,加速专家级研究方法自动化。
Dify BlogDify v1.0.0 引入插件系统,开发者可通过 Brave Search API 插件轻松集成实时搜索功能。在 Dify Studio 中创建智能代理或工作流,选用 Claude-3.5 Sonnet 等模型,并添加 Brave Search 工具实现搜索。支持在工作流中部署,或集成自定义插件扩展功能。
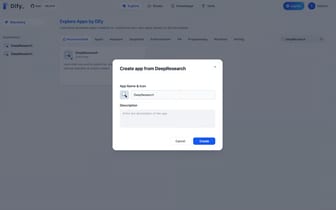
Dify BlogDify 通过节点迭代、搜索和总结,实现多步研究自动化应用 DeepResearch。该应用使用 LLM 生成查询和总结,支持 8k 上下文窗口,需 DeepSeek 和 Tavily API,部署在 Dify 平台。
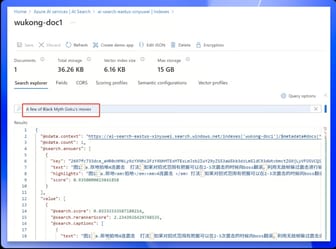
Dify Blog6565Dify 平台通过自定义工具支持 Azure AI 搜索,开发者需在 Azure 创建索引并获取 API 密钥,然后在 Dify 控制台配置工具并设置 schema,最终通过工作流调用实现 AI 驱动的搜索功能。
Dify Blog6565Dify Workflow 通过并行模式和高级迭代功能,加速 GPT-Researcher 的研究任务,将问题分解为 4-6 个独立子问题,并行提取主题形成子标题、调用 Tavily API 搜索并分析结果,最终整合为结构化报告,显著缩短研究时间并隔离错误处理。
Dify Blog混合搜索和重新排序技术显著提升 RAG 系统的文档召回率和准确率,混合搜索结合语义相关性和关键词匹配优势,重新排序技术优化候选结果排序,适用于客户服务机器人、企业知识库等场景。
Dify Blog6565Dify V0.3.12 发布,通过 Q&A 段式匹配模式提升数据检索精度,并推出 Chat 功能实现在线交互;支持 GPT-3.5、GPT-4、Claude 2 等推理模型,插件由 Dify 团队开发优化。