PyTorch Blog
EUROPA 联盟在 JUPITER 超级计算机上使用 PyTorch 和 TorchTitan 训练 1T 参数 MoE 模型
EUROPA联盟在JUPITER超级计算机上使用PyTorch和TorchTitan成功训练了参数量达951.9B的MoE模型,将单GPU的吞吐量从90提升至约1,300 tokens/s,使用了384个NVIDIA GH200 GPU。
PyTorch BlogEUROPA联盟在JUPITER超级计算机上使用PyTorch和TorchTitan成功训练了参数量达951.9B的MoE模型,将单GPU的吞吐量从90提升至约1,300 tokens/s,使用了384个NVIDIA GH200 GPU。
 vLLM Blog精选7272
NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
 NVIDIA Blog
C-BRAIN 与 NVIDIA 正利用 AI 改变痴呆症研究进程。他们通过整合此前未公开的阿尔茨海默症研究数据,包括未发表结果和受管制的专有数据,加速新疗法研发。C-BRAIN 运用混合集中式和联邦式架构保护数据隐私,部署 64 块 NVIDIA 数据中心 GPU 及云端节点,并计划引入 NVIDIA Blackwell 系统以支持其扩展目标。
 Prime Intellect Blog
Prime Intellect 发布 SYNTHETIC-2 数据集,包含四百万条经验证的推理轨迹,涵盖迄今最全面的复杂强化学习任务和验证器。该数据集通过全球计算贡献者的管线并行分布式推理协作生成,1,253块 GPU(包括49个8xH200节点、43个8xH100节点及大量消费级3090和4090 GPU)在3天内参与创建。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-2,包含 20 项复杂强化学习任务及验证推理轨迹,支持从消费级 GPU 到超大规模集群的异构计算,采用 DeepSeek-R1-0528 模型生成数据并标注难度。
Prime Intellect Blog3838Prime Mega MoE 通过融合反向传播内核,使 DeepSeek 的 Mega MoE 内核可用于训练,相比默认 PyTorch 实现 MoE 内核速度提升高达 3.11 倍,相比 Prime-RL 基线端到端训练速度提升 1.34 倍。
 Import AI4242
《人类第六感》评测显示GPT 6 Astra在直观视觉推理任务中pass@1得分53.6,远低于人类基线93.1,其中中国开源模型GLM-5.3-flash和Kimi K3分别得分26.8和25.5。
 Microsoft Research
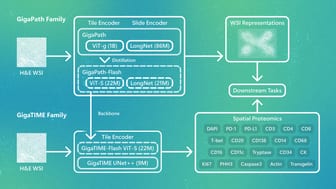
GigaPath-Flash 和 GigaTIME-Flash 通过精简的 ViT-S 编码器显著降低了计算需求,在保留性能的同时使大规模病理学研究更易实现。