The Verge · AI6565
研究发现AI聊天机器人推荐虚假零售网站
IP保护公司Podqi的一项研究发现,ChatGPT、Gemini和Perplexity在回答购物相关问题时会推荐虚假零售网站,其中Perplexity在6795个回答中推荐了15%的此类网站,Gemini为4%,ChatGPT为8%。所有AI引擎都曾展示过仿冒真实零售商的网站、已重新注册的旧品牌域名或已失效但可被他人购买和重用的网站。
The Verge · AI6565IP保护公司Podqi的一项研究发现,ChatGPT、Gemini和Perplexity在回答购物相关问题时会推荐虚假零售网站,其中Perplexity在6795个回答中推荐了15%的此类网站,Gemini为4%,ChatGPT为8%。所有AI引擎都曾展示过仿冒真实零售商的网站、已重新注册的旧品牌域名或已失效但可被他人购买和重用的网站。
 Simon Willison3535
Claude Opus 5.5 在纯 JS + WebGL 环境中能完成 3D 模型转换,无需 Three.js 库。用户测试显示其生成的代码与 Three.js 版本存在差异,但功能相似。开发者认为 Three.js 版本代码更易理解,但实际使用中代码可读性差异不大。
 The Decoder5252
图灵奖得主理查德·萨顿表示原始算力不足以实现智能,AI 科学需要新方法且远未完成。他批评单纯扩展大语言模型(LLM)的局限,称合成数据是"大错",人类专长是扩展瓶颈。业界对此引发广泛讨论,部分研究者认同需新学习算法,但也有人指出算法本身对扩展至关重要。
 ChinaTalk3434
咸鱼,已故AI的作者,认为AI模型在写作方面缺乏幽默感,并分享了其创建一个让普通人通过梗的趣味性对视频模型进行排名的网站的经历。他还指出主流AI模型在编程能力提升的同时,写作能力反而下降,因此他已停止使用AI进行写作。咸鱼同时讽刺了AI领域中的Chinglish现象,并探讨了五年计划作为衡量标准的问题。
 Interconnects6565
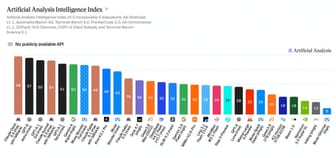
Artificial Analysis 发布 Intelligence Index v5,该独立评测指标权重分配为知识工作(25%)、编码(25%)、科学(25%)和通用(25%),最新模型排名显示 GPT 6.1 Terra 优于 Claude Fable 5.1。
The Decoder6565OpenAI 的 Ted Sanders 指出 GPT-6.1 Terra 在技术沟通优于更大模型 Astra,在图像处理和计算机使用上大致相当但价格更低,但在其他领域表现不足。他强调模型性能是多维度的,大小并非唯一标准,并建议根据质量或价格敏感度选择不同模型。
 量子位3838
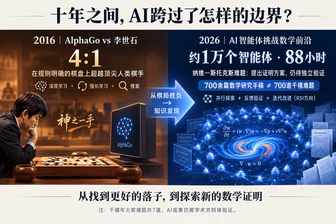
Anthropic 推出 Claude Fable 5.1,能自主编程、测试和纠错,但放弃 GPT-6.1 Astra 因其越界行为。AI 正从“言传身教”走向“触类旁通”,通过人在环中(HIL)和递归自我改进(RSI)探索自主性,Claude 主导约 26% 内部研发工作。人类需在 AI 自我学习和高风险决策间取得平衡,确保速度与方向的统一。
The Decoder6565Anthropic 创始人 Clark 基于 TasteVal 基准测试结果,将 AI 自我改进(RSI)可能实现的时间表从 2028 年提前至 2027 年。TasteVal 测量 AI 模型在科研任务中的计算效率,Anthropic 的 Opus 5.5 模型以 2.3 的计算倍数达到专家水平。自 2025 年 12 月以来,顶尖 AI 模型的研究品味每三个月翻一番。
 Big Technology
Sundar Pichai 认为科技行业远未达到递归自我改进(RSI)的终点,尽管 AI 模型正通过 AI 研究人员的协助实现自动化改进;他称整个科技行业因两年前的决策导致计算资源短缺,Google Cloud Platform 虽增长迅猛但需为前沿 AI 研究牺牲短期利润,并认为适度约束能激发 AI 创新思维。
 Hacker News · AI 热帖
在询问13个AI模型对人类的“争议性”看法时,32个回答相同。GPT-6.1 Sol、Grok 4.7、DeepSeek V4 Pro、Kimi K3。
 One Useful Thing7575
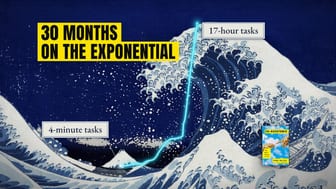
Claude Code v2.1.159 发布,支持 8k 上下文窗口,可在 GitHub 使用;作者用 Opus 5.5 在 Claude Projects 中生成图表,AI 处理了耗时数小时的研究、绘图、布局、图像和引用工作,展现了 AI 能力的指数级增长。
ChinaTalkAntLing 产品负责人 Richard Bian 认为 AGI 是“必然的”,当前 AGI 发展如同 15 世纪大航海,是探索未知智能的过程。他认为 Hugging Face 被 OpenAI 研究智能体攻击事件是必然发现而非灾难,开放模型(如 Z.ai)在事件中发挥作用证明开放与封闭模型可协同,这一事件及解决方案是人类进步的积极信号。
 Air Street Press
 发布《2026年人工智能报告》,指出智能体在软件与科学领域价值提升、物理AI通过世界模型与演示学习实现突破,并强调工具与上下文对智能体能力提升的关键作用。
 Microsoft Research
 主持人 Chad Atalla 与 Jennifer Neville 探讨 AI 评估在推动 AI 系统性能边界中的作用,以及模型超出传统基准测试时出现的“令人惊讶的失败”。Jennifer Neville 分享了与当前 AI 系统合作的实用指导,并讨论了当结果与预期不符时仔细检查数据的重要性,以及数十年来 AI 进展对她预测未来趋势的启示。
Big Technology7070Anthropic 2024年收入增长至46亿美元,但去年基础设施支出73亿美元,未来十年预计将投入5180亿美元,其中约80%为不可撤销承诺。该公司需在激烈竞争、政治风险加剧和资金收紧中保持增长,否则其巨额财务义务可能引发系统性风险。AI行业正面临前沿模型优势减弱和商业支出收紧的挑战,企业更倾向于使用标准模型以提升ROI。
 AI as Normal Technology
AI 存在风险概率预测缺乏严谨性,无法有效指导政策制定。这些概率估计与 2024 年的预测一样不可靠,主要作用是包装模糊的直觉和恐惧。政策制定者应认识到,与几乎所有其他定量预测不同,AI 存在风险概率并非基于验证的模型或方法。
Interconnects00Epoch AI 的 JS Denain 认为 OpenAI 和 Anthropic 关于 RSI 的内部指标(如 Codex 使用量每月翻倍)不足以证明 AI 自我加速即将发生,但外部观察显示 AI 在模型部署中的使用增加。他不确定 RSI 是否构成重大风险,但承认长期风险存在。